Étude de cas 02 · Data · Backend · Énergie
SparkMeter Data Automation
Collecte les relevés de compteurs électriques, historise les corrections et alimente rapports, graphiques et Google Sheets.
- Rôle
- Architecture, modèle de données, backend, interfaces et tests
- Catégorie
- Data · Backend · Énergie
- Stack
- Laravel 13 · Vue 3 · PostgreSQL
01 — Contexte
Les équipes d'exploitation et les analystes d'un réseau électrique suivaient les consommations des compteurs connectés SparkMeter à partir d'exports et de Google Sheets, avec des automatisations qui rapprochaient les données par le nom des abonnés.
02 — Problème
Le suivi reposait sur le nom des abonnés : un changement de nom ou de compteur cassait les rapports.
03 — Solution
Une application web réunit la collecte, le référentiel des sites et des compteurs, les rapports et les analyses. Les relevés sont validés puis enregistrés dans PostgreSQL, qui devient la source de référence. Chaque point de consommation a un code métier stable, indépendant du nom de l'abonné, et une recollecte récupère les corrections publiées tardivement en conservant les valeurs avant et après.
04 — Fonctionnalités
Collecte multi-sites
Import des CSV SparkMeter au pas natif de quinze minutes, reprise après la dernière journée connue.
Historique des corrections
Nouvelles mesures, données inchangées et valeurs corrigées sont distinguées et tracées.
Référentiel stable
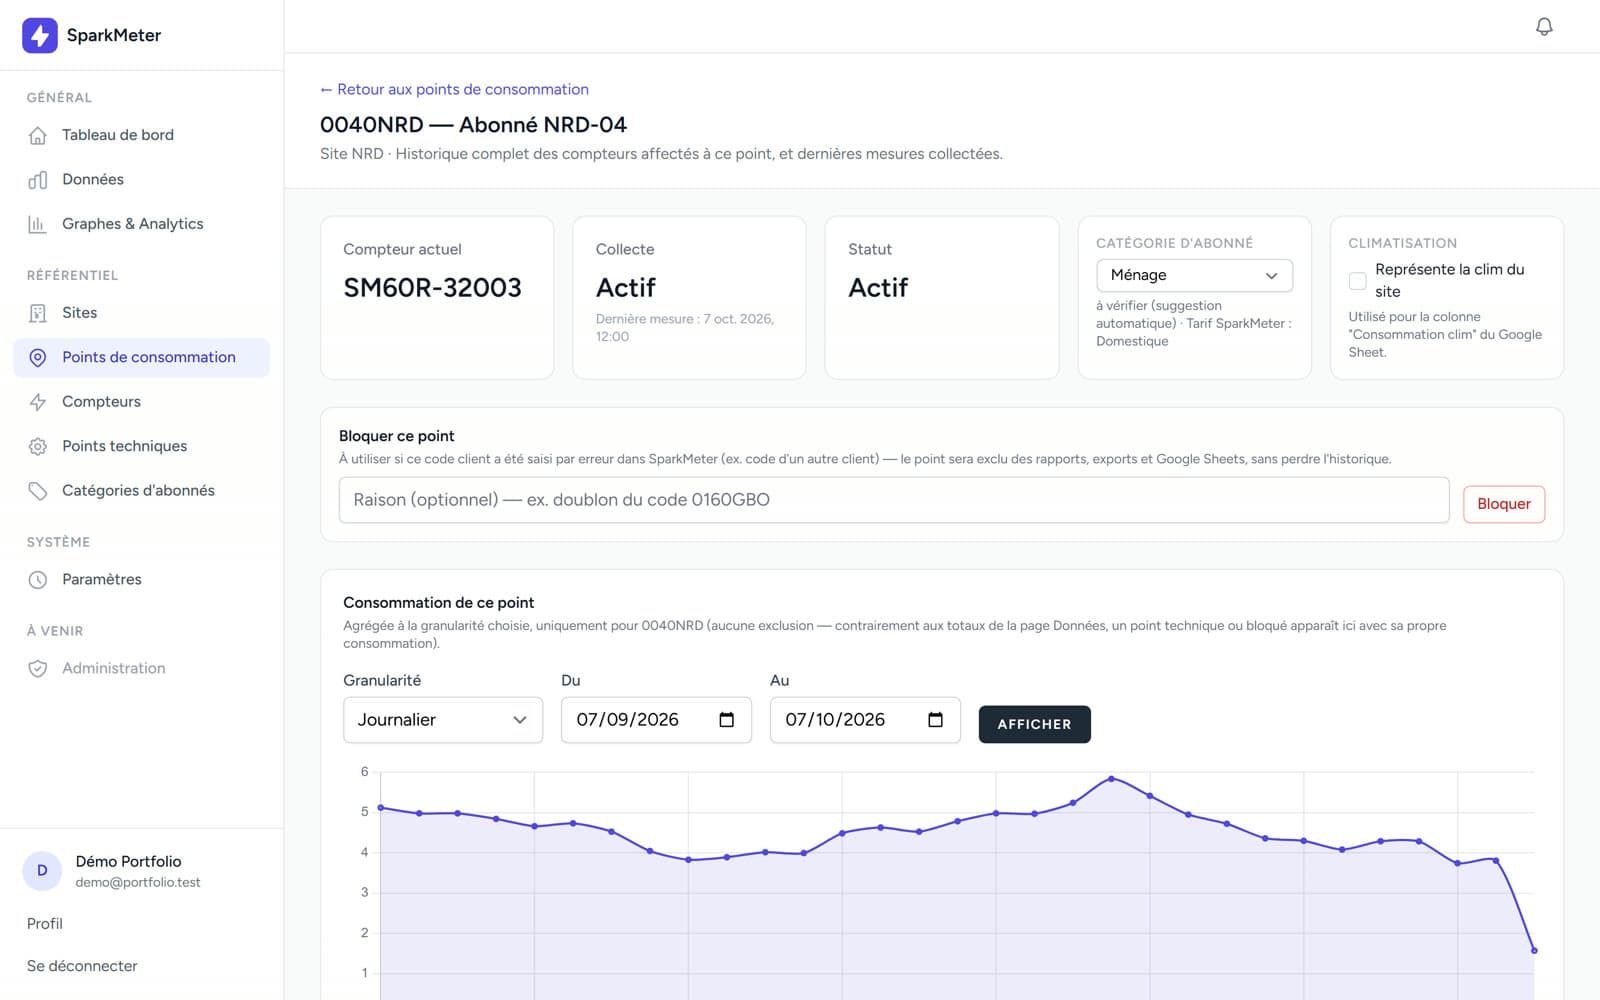
Sites, points de consommation et compteurs, avec l'historique des affectations.
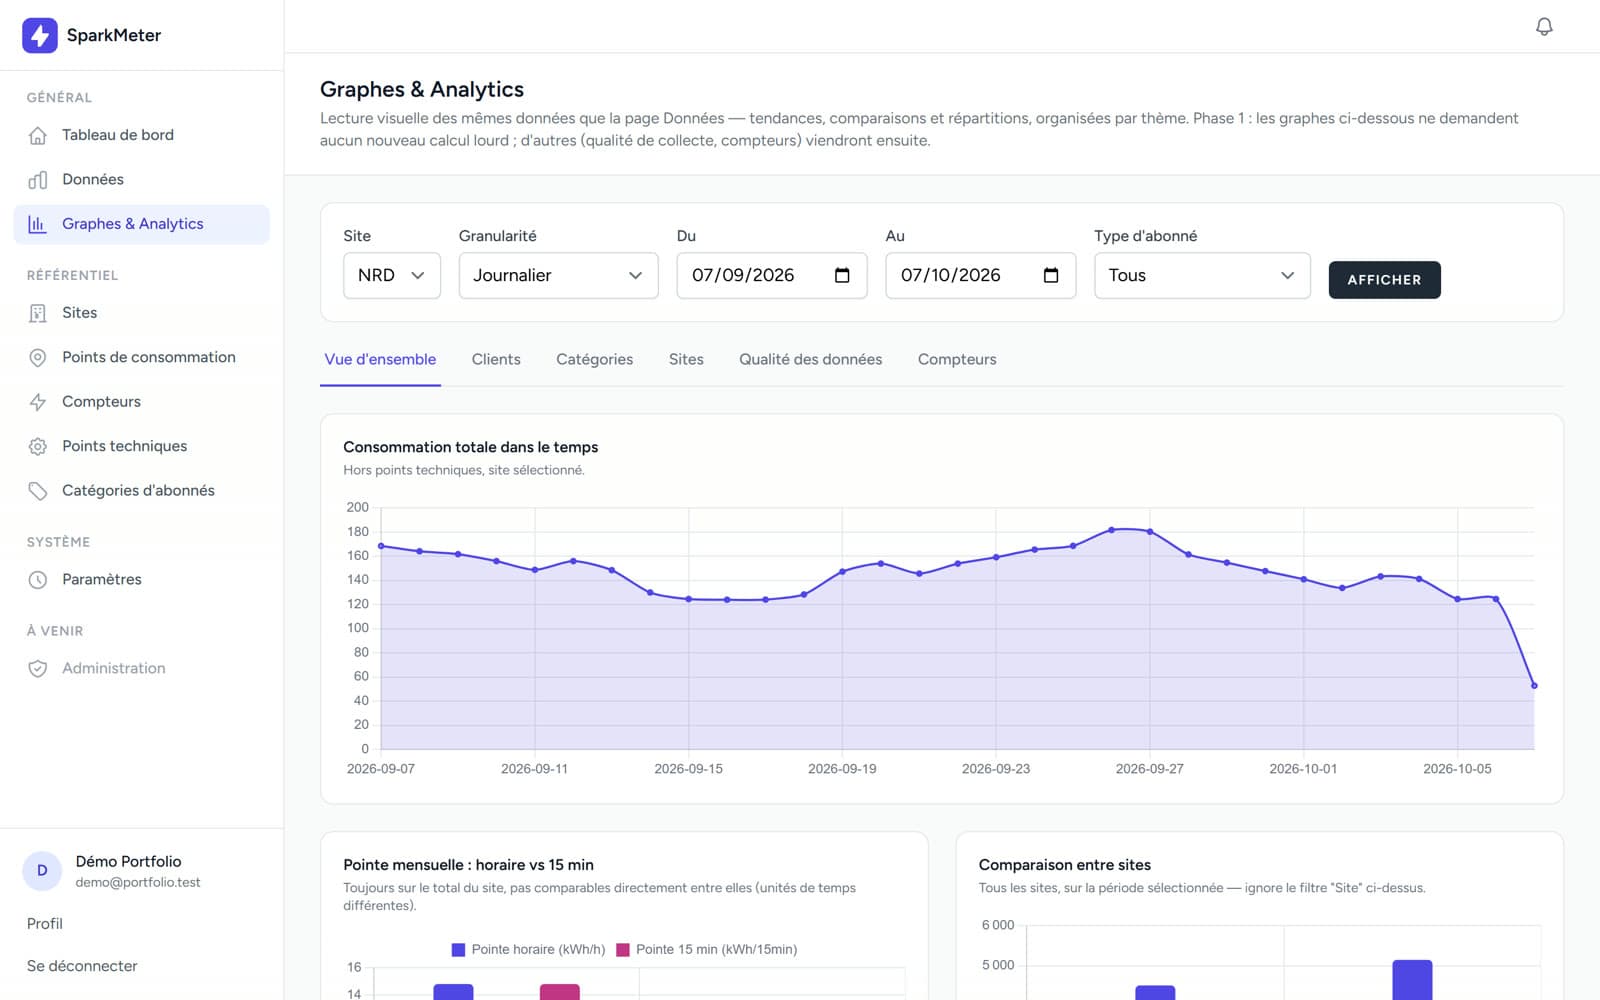
Rapports filtrables
Par site, période et catégorie d'abonnés, de quinze minutes à l'année.
Analyses visuelles
Courbes, comparaison entre sites, répartition par catégorie et Pareto.
Restitutions
Synchronisation Google Sheets, exports Excel et CSV, archives des fichiers source.
05 — En images
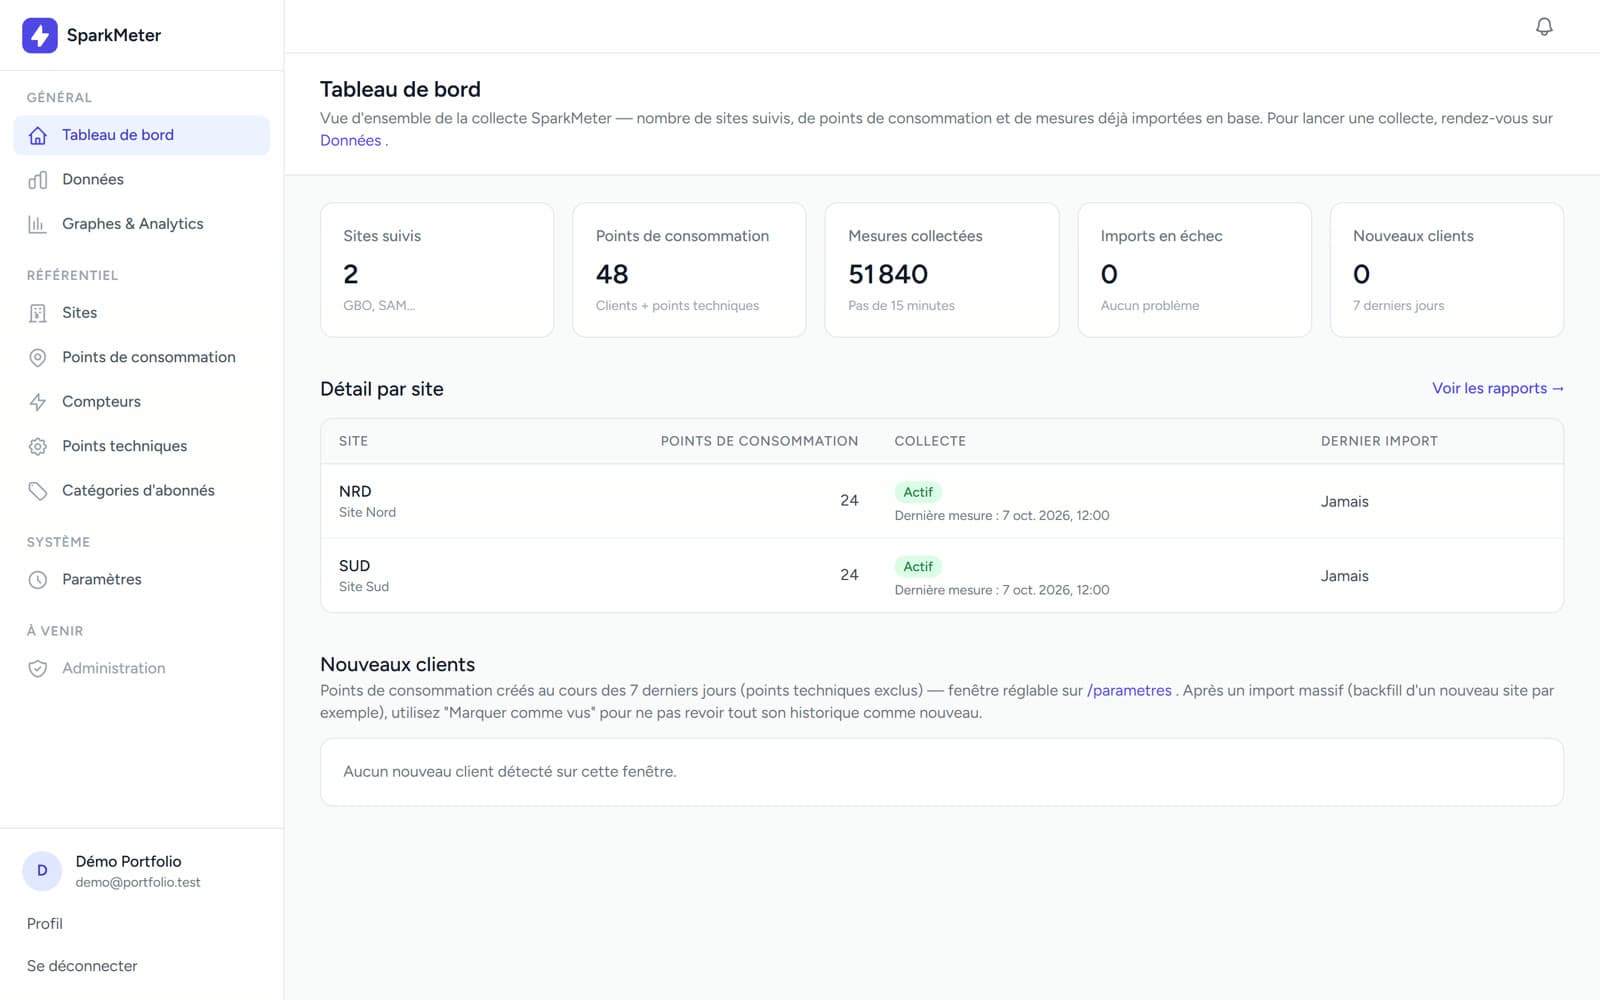
Tableau de bord de la collecte par site 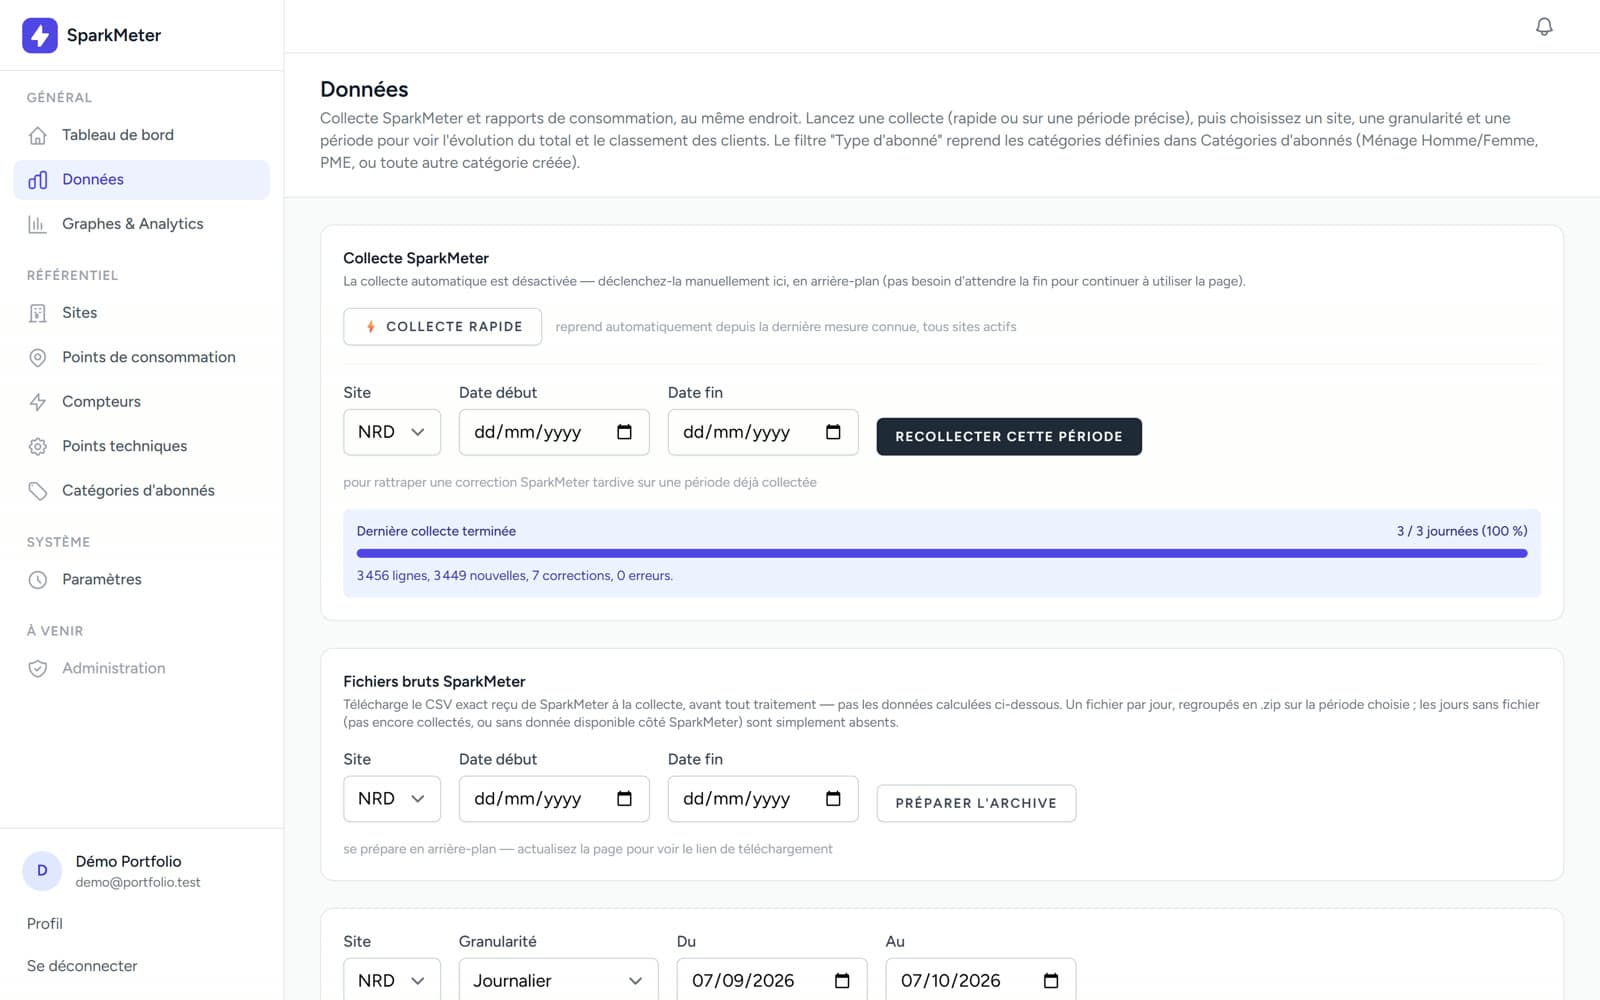
Collecte, recollecte et rapports de consommation
06 — Architecture
- API SparkMeterCSV · multi-sites
- Collecte & validationjobs · lots · reprise
- PostgreSQLmesures · corrections
- Services de rapportsagrégations SQL
- Vue · Sheets · Excelrestitutions
Le backend Laravel est organisé en contrôleurs, services métier, modèles et jobs ; Inertia transmet les données des pages à l'interface Vue.
Les opérations longues — collecte, synchronisation, archives — passent par des jobs en arrière-plan, et les mêmes services d'agrégation alimentent les rapports web et les restitutions externes.
07 — Défis techniques
Défi
Conserver le suivi malgré les changements de compteur.
Solution
Séparation entre point de consommation, compteur physique et affectations datées, avec un code métier stable.
Défi
Intégrer les corrections sans perdre l'historique.
Solution
Unicité point/période, comparaison à la recollecte et conservation des valeurs avant et après.
Défi
Traiter de longs historiques sans bloquer l'interface.
Solution
Traitement par lots, index composites, jobs en arrière-plan et points de sauvegarde PostgreSQL par ligne.
Défi
Éviter les totaux trompeurs.
Solution
Exclusion des compteurs techniques des totaux et classements, tout en gardant leurs vues individuelles.
08 — Mon intervention
- Architecture et modèle de données énergétique
- Backend Laravel et interfaces Vue / Inertia
- Intégration des API SparkMeter et Google Sheets
- Pipeline de collecte, validation et rapprochement
- Traitements asynchrones et suivi des collectes
- Rapports, graphiques et exports
- Optimisation des requêtes et de la mémoire
- Tests automatisés
09 — Stack
- Backend
- PHP 8.3, Laravel 13, Eloquent, Jobs & Queues, Scheduler
- Frontend
- Vue 3, Inertia.js 2, Tailwind CSS, Chart.js
- Données
- PostgreSQL, Redis, MinIO (S3)
- Intégrations
- API SparkMeter, Google Sheets API, Laravel Excel
- Qualité
- PHPUnit, Laravel Pulse, Telescope
10 — Résultats
15 min
pas des relevés importés, au plus près de la source
3
formats de restitution : Google Sheets, Excel et CSV
1
base de référence commune aux rapports, graphiques et tableurs